BrutAIsm · Masa de cercetare
IA – Imitația Aparențelor
De unde vine aerul „de AI” al imaginilor
Imaginile primelor generatoare text-to-image, din 2022–2023, aveau un aspect anume: lumină curată, contururi nete, piele de porțelan, culori prea bogate. Le recunoșteai de departe. Generatoarele de azi l-au atenuat atât de mult încât, în testele recente, oamenii le deosebesc de fotografii doar puțin mai bine decât dacă ar ghici. Nu printr-o idee nouă, ci mai degrabă prin forță: mai multe date, imagini mai mari, o grilă internă mai încăpătoare, reglaje pe fotografii alese pentru realism. Aerul nu a dispărut. S-a ascuns mai bine. Noi am lucrat cu SDXL, un model public din 2023, pe care îl putem desface piesă cu piesă; la el, mecanismul încă se vede. L-am căutat în suprafața imaginilor, în felul în care se formează ele pas cu pas, în cuvintele din prompt și în ce crede modelul despre sursa pe care o imită. Un tablou are materie pentru că a fost făcut: vopsea trasă cu pensula, pânză țesută, un secol de uscare și crăpături. Modelul n-a atins niciodată o pânză. A învățat din fotografii după tablouri și imită felul în care arată materia. Iar lumea o vede printr-o lentilă pe care nu o arată: cea a fotografiilor din care a învățat.
Cum se citește. Pe această foaie nu antrenăm nimic: schimbăm parametri și ne uităm înăuntru. Pe aceeași coloană, același seed, adică același zgomot de pornire; diferențele dintre rânduri vin doar din parametrul schimbat. Standard model e SDXL așa cum îl descarcă oricine, fără nicio modificare: martorul tuturor comparațiilor. Celelalte modele sunt prezentate acolo unde apar.
poppies, seen up close · left: the public model, asked for the same painting · right: Ștefan Luchian, Maci și spice în ulcică, MNAR, photographed
| STANDARD MODEL, asked for the same painting · 1:1 | high-pass: only the fine detail | photograph of the painting · 1:1 | high-pass: only the fine detail | |
|---|---|---|---|---|
 |  |  |  |
Detaliul modelului e contur. Detaliul tabloului e materie.
Cum face un model o imagine
„Maci și spice în ulcică”
1 Promptul e tăiat în tokenuri: cuvinte sau bucăți de cuvânt.
0.12 −0.83 0.45 1.07 −0.31 0.66 −0.92 0.18 …
Encoderul de text (CLIP) face din fiecare token un șir de 2048 de numere.

2 Zgomot pe grila latentă, de 128 × 128. Seed-ul îl alege.


3 Pașii (steps): zgomotul e curățat treptat, spre ce se potrivește cu promptul; CFG decide cât de insistent. Aici: estimările de la pașii 1, 4 și 7.


Rezultatul nu e o imagine, ci grila latentă: 128 × 128 de puncte, fiecare cu 4 numere (4 canale).

4 Decodorul VAE face din fiecare punct 8 × 8 pixeli: 1024 × 1024.
Pașii și grila latentă: partea a II-a · CFG: partea a III-a · tokenurile: partea a IV-a
I · Fricțiunea
Materie și contur
Cum se citesc imaginile gri de lângă fiecare tablou: sunt aceleași imagini, trecute printr-un filtru high-pass, care păstrează doar detaliul fin (margini, textură, granulație, tușă). Unde stratul e gri uniform, nu e niciun detaliu. Nu vă uitați la flori, ci la fundal: acolo e diferența. În fotografiile după tablourile lui Luchian, fundalul e la fel de încărcat ca florile. Motivul e simplu: pânza e țesută peste tot, pensula a trecut peste tot, vopseaua a crăpat peste tot. Materia nu știe ce reprezintă. Modelul Luchian e modelul public, căruia în „Adio, flori” i-am adăugat un mic strat învățat (un LoRA) din 17 tablouri cu flori de Luchian din colecția MNAR. A văzut exact aceste tablouri și totuși fundalul lui e aproape gol, iar detaliul se strânge în linii nete în jurul fiecărei forme. Modelul a învățat detaliul ca pe o proprietate a lucrurilor, nu a materiei: îl pune unde e un mac, nu unde e pânză. Standard model face la fel cu un portret: detaliu în păr, în gene și în dantelă, acolo unde se uită ochiul, și piele netedă.
Detaliul modelului e contur. Detaliul tabloului e materie.
| Maci și spice în ulcică · 10.580 | finish layer | Albăstrele · 7704 | finish layer | Maci în vas alb · 9766 | finish layer | |
|---|---|---|---|---|---|---|
| Ștefan Luchianphotographs of the paintings, MNAR | 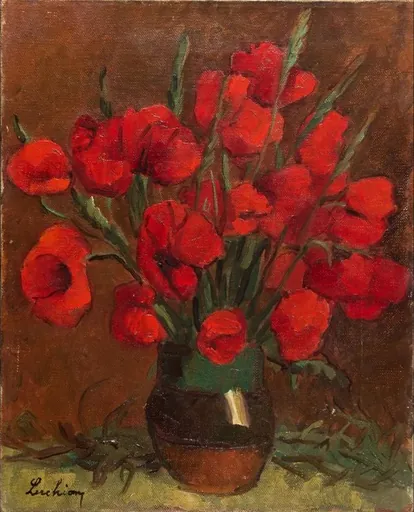 |  |  |  |  |  |
| picture | finish layer | finish · seed 1002 | finish · seed 1003 | “a portrait of a woman, photo” | finish layer | |
|---|---|---|---|---|---|---|
| Luchian · Standard model |  |  |  |  | 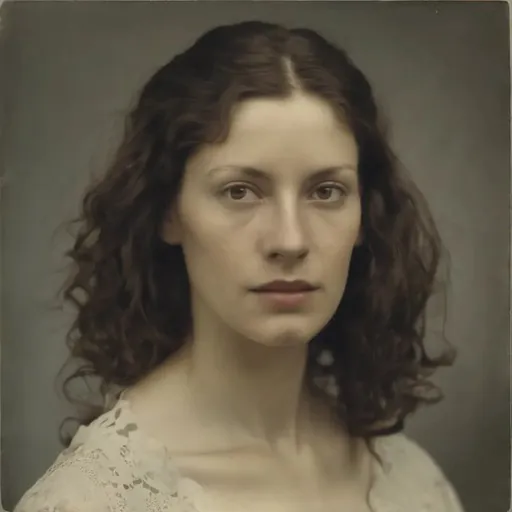 |  |
De aproape
La mărime reală, diferența se vede și fără filtru. Căutați zonele în care „nu se întâmplă nimic”: fundalul tabloului „Albăstrele”, gâtul portretului generat. În tablou, nimicul are relief și crăpături. În imaginea generată, nimicul e neted, pentru că modelul n-avea niciun motiv să pună ceva acolo.
| Albăstrele · background, 1:1 | finish layer | STANDARD MODEL portrait · skin and neck, 1:1 | finish layer | |
|---|---|---|---|---|
 |  |  |  |
Am măsurat. Diferența apare peste tot.
Pentru 7 tablouri cu flori, am pus alături fotografia după tablou și imaginile generate din aceeași descriere, de modelul Luchian și de Standard model. Am comparat cât detaliu fin au zonele plate (fundalul, interiorul petalelor) față de contururi. În toate cele 7 perechi, imaginile generate au mai puțin: în medie, cam jumătate din cât au fotografiile după tablouri. Diferența nu vine deci din micul strat învățat din doar 17 tablouri. Apare la fel la modelul public, întreg. Unde anume se pierde materia arătăm în partea a II-a: nu acolo unde ne-am fi așteptat.
Atunci de ce e greu să recunoști o imagine AI?
Pentru că diferența nu e o regulă fixă. Modelele mai noi lucrează cu o grilă latentă de 16 canale în loc de 4, care păstrează mai mult detaliu fin; utilizatorii adaugă pori și granulație de film cu LoRA-uri „de realism”. Cercetătorii găsesc totuși urme statistice: modelele de difuzie subestimează frecvențele înalte, adică exact detaliul fin de pe această foaie. Un detector antrenat pe imaginile unui model le recunoaște aproape perfect. Dar dă greș la modele pe care nu le-a văzut și după o simplă comprimare sau redimensionare, adică după drumul obișnuit al oricărei imagini pe internet.
Fricțiunea nu se generează. Se imită.
Un tablou sau o fotografie e o urmă. Pensula a atins pânza, lumina a atins filmul, timpul a crăpat vopseaua: imaginea poartă semnele acestui contact cu lumea. Modelul nu are contact cu nimic. A învățat, din milioane de fotografii, cum arată urmele, și le pune acolo unde ne așteptăm să le vedem. Teoreticianul John May numește asta imagine statistică: calculată din date adunate, fără ca lumea să o fi atins. Chiar când modelele vor genera crăpături perfecte, ele vor fi puse acolo de o statistică, nu de timp.
finish layer: high-pass filter, the picture minus a copy of itself blurred over 6 px · measurement: mean fine detail away from the strongest 15% of edges, divided by the mean on them
II · Cum se formează
Trei sferturi din pași sunt lustru
Citiți fiecare rând de la stânga la dreapta: e aceeași imagine, așa cum și-o închipuie modelul la pași diferiți. Totul pornește de la zgomot, ales de seed. În 28 de pași (steps), modelul scoate câte puțin zgomot și, la fiecare pas, estimează cum va arăta imaginea terminată. Urmăriți două lucruri: cât de devreme apare compoziția (la pasul 4 e deja acolo) și cât de târziu apare detaliul (dantela portretului vine abia în ultimii pași). De ce în ordinea asta? Pentru că modelul nu ghicește o imagine anume, ci media tuturor imaginilor care s-ar potrivi cu ce vede. Când zgomotul e mult, se potrivesc mii de imagini, iar media lor e o pată încețoșată: ce au în comun e doar așezarea mare a formelor. Pe măsură ce zgomotul scade, variantele posibile se împuținează și detaliul poate apărea. Fără niciun cuvânt (ultimul rând), nimic nu restrânge variantele, iar imaginea rămâne ceață până la jumătate.
Compoziția e hotărâtă în primul sfert din pași. Restul o face să pară terminată.
| step 1 | step 2 | step 4 | step 7 | step 14 | step 21 | step 28 | |
|---|---|---|---|---|---|---|---|
| LuchianPoppies and wheat ears in a jug |  |  |  |  |  |  |  |
| Standard model“a portrait of a woman, photo” |  |  |  |  |  |  |  |
| Standard modelthe empty prompt “” |  |  |  |  |  |  |  |
Imaginea dinaintea imaginii
Modelul nu lucrează cu pixeli, ci pe o grilă mică de numere, numită spațiu latent: 128 × 128 de puncte, fiecare cu 4 valori, adică 4 canale. Pe fiecare rând vedeți cele 4 canale ca imagini gri, mărite fără netezire: fiecare pătrățel e un punct, care va deveni 8 × 8 pixeli. Cele patru numere nu sunt culori. Sunt un cod învățat la antrenare de o componentă separată, VAE-ul, care a trebuit să strângă cât mai mult din imagine în cât mai puține numere. De aceea primul canal seamănă cu luminozitatea: e informația cea mai utilă. Celelalte amestecă culoare și textură și nu se lasă citite cu ochiul. Comparați previzualizarea color cu imaginea finală: compoziția și culorile sunt deja hotărâte în grilă. Decodorul VAE doar o traduce în pixeli.
Compoziția stă într-o miniatură de numere.
| channel 1 | channel 2 | channel 3 | channel 4 | colour preview | decoded by the VAE: the final image | |
|---|---|---|---|---|---|---|
| Standard modelPoppies and wheat ears in a jug |  |  |  |  |  |  |
| Luchianthe same description | | | | |  | |
| Standard model“a portrait of a woman, photo” |  |  |  |  |  |  |
| Standard modelthe empty prompt “” |  |  |  |  |  |  |
Imitația impune o ierarhie a detaliilor.
Am făcut și drumul invers. Am dat encoderului VAE fotografia tabloului „Maci și spice în ulcică”, l-am lăsat s-o transforme în cele 4 canale, apoi am decodat-o la loc. Țesătura pânzei a supraviețuit aproape întreagă: în zonele plate rămâne 45% din detaliul contururilor, față de 50% în fotografie. Grila de 4 canale poate deci ține materia tabloului. Când îi cerem însă modelului să facă singur același tablou, din descriere, în zonele plate rămân 22% la modelul Luchian și 13% la Standard model. Materia nu se pierde la traducerea în numere. Se pierde la generare. O explicație simplificată: la fiecare pas, modelul estimează media imaginilor care s-ar potrivi. Conturul unui mac e cam în același loc în toate variantele posibile, așa că trece prin medie neatins. Țesătura pânzei și crăpăturile sunt de fiecare dată altfel și, în medie, se anulează. Ultimii pași mai adaugă o parte din ele, dar mai puțin decât în realitate: cercetătorii au arătat că modelele de difuzie subestimează sistematic detaliul fin.
| photograph of the painting | the same photograph, encoded into the 4 channels and decoded back | LUCHIAN model, generated from the description | STANDARD MODEL, generated from the description | |
|---|---|---|---|---|
| detail, 320 × 320 px |  |  |  |  |
| finish layer |  |  |  |  |
| fine detail of the flat areas, as a share of the outlines’ detail | 50% | 45% | 22% | 13% |
În sală: imagini fără lustru
Câteva lucrări din sală generează în timp real, cu StreamDiffusion. Ca să țină pasul, folosesc modele care fac o imagine în 1–4 pași în loc de 28, de obicei fără CFG (partea a III-a) și cu un decodor VAE mai mic, Tiny VAE. Lustrul n-are timp să se așeze: cadrele trec unul în altul în forma lor compozițională, mai brută, așa cum arată pașii timpurii de mai sus.
steps: the model’s estimate, at that step, of the finished image (x0) · latent: 128 × 128 × 4 values, shown at their real resolution · VAE: variational autoencoder; its encoder turns pixels into the latent grid, its decoder turns the grid back into pixels · round trip: SDXL VAE, same measurement as in part I
III · CFG
Împins departe de <nimic>
Pe fiecare rând, același seed și același prompt; se schimbă doar CFG scale, parametrul pe care îl reglează oricine generează imagini, de obicei în jur de 7. Ce face: la fiecare pas, modelul face două estimări, una cu promptul și una fără. Diferența dintre ele e „ce adaugă promptul”. CFG scale spune de câte ori se amplifică această diferență. Citiți rândurile de la stânga la dreapta. La CFG 1, diferența nu e amplificată deloc, iar modelul abia ascultă promptul: portretul nici nu devine portret. Cu cât CFG crește, cu atât imaginea devine o versiune mai apăsată și mai tipică a promptului. Macii modelului Luchian se fac tot mai plați, mai saturați, cu contururi tot mai tari: aerul „de Luchian” nu e adăugat, e exagerat. Portretul alunecă spre o fotografie de studio veche, sepia: pentru „portretul unei femei, fotografie”, varianta cea mai tipică pare să fie una de arhivă, de felul celor cu care colecțiile digitizate au umplut internetul. Aceeași exagerare, repetată de la o generație la alta, duce în „Autofagie” la prăbușire.
O parte din lustru vine din direcția în care e împinsă imaginea, nu din ce scrie în prompt.
| CFG 1 (no push) | CFG 2 | CFG 3.5 | CFG 6.5 (usual range) | CFG 10 | CFG 15 | |
|---|---|---|---|---|---|---|
| Standard model“a portrait of a woman, photo” |  |  |  |  |  |  |
| LuchianPoppies and wheat ears in a jug |  |  |  |  |  |  |
Ce se întâmplă dacă „nimic” înseamnă „schiță”
Câmpul negative prompt, textul de care vrei să fugă imaginea, rămâne de obicei gol. Atunci, estimarea „fără prompt” de mai sus se face cu promptul gol, iar CFG împinge imaginea departe de ea. Altfel spus, fiecare imagine fuge de ceea ce înțelege modelul prin „nimic”. Ca să vedem cât contează asta, am construit varianta C: același Standard model, cu o singură modificare. Printr-un calcul direct, fără reantrenare (metoda UCE, aceeași din „Adio, flori”), am rescris sensul textului gol: acum, pentru model, „nimic” înseamnă „o schiță brută, neterminată”. E ca și cum orice imagine ar avea, pe ascuns, negative prompt „schiță”. Comparați rândurile două câte două: sus, modelul neatins; jos, varianta C, cu același seed. Imaginile care erau deja lustruite abia se mișcă. Cele care erau gravură sau creion fug de schiță și devin picturi în culori. Lustrul nu vine deci doar din ce ceri. Vine și din fuga de ce consideră modelul a fi „nimic”: schimbi sensul lui „nimic” și se schimbă direcția lustrului.
| seed 1001 | seed 1002 | seed 1003 | |
|---|---|---|---|
| “a landscape”Standard model |  |  |  |
| C · “” → sketch |  |  |  |
| seed 1001 | seed 1002 | seed 1003 | |
|---|---|---|---|
| “a portrait of a woman”Standard model |  |  |  |
| C · “” → sketch |  |  |  |
CFG: classifier-free guidance, Ho & Salimans, 2022 · CFG scale 1 = conditional prediction only · same seed along each row · variant C: UCE edit of the cross-attention, “” → “a rough unfinished sketch”, all other words untouched
IV · Cuvintele magice
Stilul nu stă în cuvinte
Pe forumuri circulă rețete de prompt: „masterpiece, best quality, highly detailed, 8k, ultra realistic, cinematic, award-winning”. În sală, 7777 SlopMachine, mașina de jocuri reconvertită, le transformă în simboluri de cazino. Le-am testat. Cu aceeași metodă UCE, am redirecționat două familii de tokenuri: în varianta A, cuvintele de „calitate” (masterpiece, highly detailed, 8k, cinematic, award-winning…) duc la „a sketch”; în varianta B, cuvintele de mediu (photo, oil painting, watercolor, 3D render…) duc la „a pencil sketch”. Cum se citesc tabelele: sus, modelul neatins; dedesubt, aceeași comandă și același seed, cu cuvintele redirecționate. Dacă rândurile diferă, cuvintele contau. Când cuvintele sunt în prompt, rândurile diferă radical: portretul devine schiță, fotografia devine desen. Când promptul e simplu, „an old man” iese practic identic, cu tot aerul lui lucios de fotografie de studio. Deci nu cuvintele îl aduc: e felul implicit al modelului de a arăta. Portretul de femeie alunecă totuși spre desen, probabil pentru că, în encoderul de text, cuvintele nu sunt izolate: „portrait” e vecin cu „masterpiece” și „photo”, iar redirecționarea îl atinge și pe el.
Cuvintele magice decorează. Stilul de AI e felul implicit al modelului de a arăta.
Cu „masterpiece, highly detailed, 8k” și „photo” în prompt
Cuvintele merg unde au fost trimise.
| seed 1001 | seed 1002 | seed 1003 | |
|---|---|---|---|
| “a masterpiece portrait of a woman, highly detailed, 8k”Standard model |  |  |  |
| A · quality → sketch |  |  |  |
| seed 1001 | seed 1002 | seed 1003 | |
|---|---|---|---|
| “a photo of an old man”Standard model |  |  |  |
| B · medium → pencil |  |  |  |
Fără ele: prompturi simple
Rândurile seamănă: lustrul nu venea din cuvinte. Excepția, portretul de femeie, arată cât de încâlcite sunt cuvintele în encoderul de text.
| seed 1001 | seed 1002 | seed 1003 | |
|---|---|---|---|
| “an old man”Standard model |  |  |  |
| A · quality → sketch |  |  |  |
| seed 1001 | seed 1002 | seed 1003 | |
|---|---|---|---|
| “a portrait of a woman”Standard model | | | |
| A · quality → sketch |  |  |  |
| B · medium → pencil |  |  |  |
same seeds in every row · the variants change only where the redirected tokens lead; nothing is retrained · word diversion: UCE, Gandikota et al., WACV 2024
V · Lentila
O mărime cerută adresează o epocă
La antrenare, SDXL a primit, alături de fiecare imagine, două informații despre sursa ei. Prima: cât de mare era originalul. O fotografie de 200 px de pe un site vechi și una de 4000 px de la un aparat modern ajung la aceeași mărime de lucru, dar modelul află de unde a pornit fiecare. A doua: decupajul. Imaginile de antrenare trebuiau să fie pătrate, așa că din cele dreptunghiulare s-a tăiat o bucată; modelul a aflat, pentru fiecare, câți pixeli s-au tăiat de sus și din stânga. Scopul era ca modelul să nu învețe din greșeală că subiectele apar tăiate de margini, cu capete fără creștet. La generare, aceste numere (original_size și crop_coords_top_left, numite micro-conditioning) au valori implicite, „original mare” și „nedecupat”, pe care utilizatorul obișnuit nu le vede. Noi le-am schimbat. Imaginea are mereu 1024 px; doar pretindem altă sursă. Cu același seed și același prompt, un „original de 128 px” dă un portret pictat, de secol XIX; 256–512 dau fotografii sepia; 2048 dă un portret modern, clar. De ce? Pe internet, imaginile mici sunt mai ales scanări vechi, miniaturi și arhive; cele mari, fotografii recente. Modelul a învățat asocierea: imagine mică, imagine veche. Iar un decupaj pretins îi spune că imaginea e o bucată dintr-una mai mare: iese un instantaneu, un fragment, o față tăiată de margine.
Modelul nu vede lumea. Vede fotografiile lumii, cu tot cu mărimile, decupajele și drepturile lor de autor.
Cine apare în poză depinde de un număr arareori considerat la momentul generării
Comparați rândurile pe coloane. Mărimea pretinsă nu schimbă doar claritatea, ci genul de imagine: la stânga, ilustrații și portrete pictate, înrămate; spre dreapta, fotografii de studio, apoi fotografii moderne; cu decupaj, instantanee și fragmente, ca fața tăiată de margine din al doilea rând. Odată cu genul se schimbă și omul din imagine. Pe primul rând, pentru același „a woman” și același seed, apar pe rând o femeie asiatică, apoi una de culoare, într-un portret de studio alb-negru, apoi, cu decupaj, o fotografie color sub un rând de „Copyright”. Motivul: în datele de antrenare, fiecare gen de imagine vine cu oamenii pe care îi arată de obicei. Ilustrația de epocă, portretul artistic de studio și fotografia de agenție au populații diferite. Modelul nu alege o persoană, ci un gen de imagine, iar persoana vine odată cu el. Rândul de „Copyright” e urma directă a fotografiilor de agenție din care a învățat.
| original_size 128 px | 256 px | 512 px | 1024 px | 2048 px | claimed crop | claimed crop, larger | |
|---|---|---|---|---|---|---|---|
| “a woman”seed 1002 |  |  |  |  |  |  |  |
| “a woman”seed 1001 |  |  |  |  |  |  |  |
| “a portrait of a woman, photo”seed 1001 |  |  |  |  |  |  |  |
| “a landscape painting of hills and a village”seed 1001 |  |  |  |  | 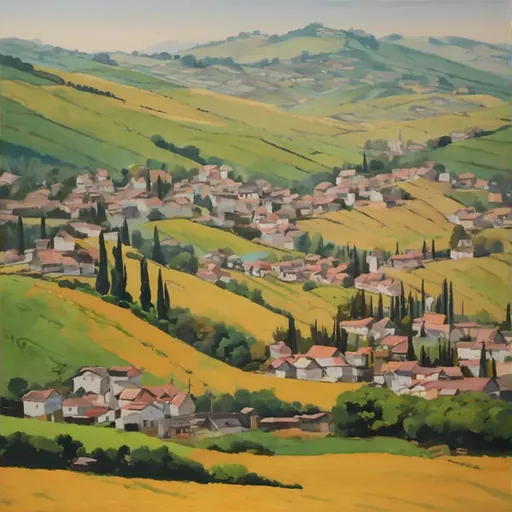 | 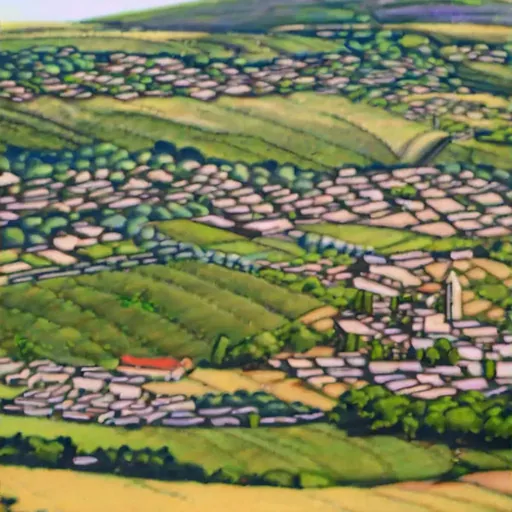 |  |
Dar nici nimicul nu e neutru:
Cu promptul gol, singura informație pe care o primește modelul e sursa pretinsă. Și atunci arată ce conțin de obicei imaginile de acel fel. O „sursă de 128 px” aduce interioare încărcate, covoare, modele textile, ca scanările vechi; mărimile mari aduc mai ales obiecte și clădiri fotografiate clar; decupajul aduce fragmente de stradă, vitrine, chiar o captură de ecran. Acesta e „nimicul” de care fuge CFG în partea a III-a: nu un gol, ci o medie a internetului, care se schimbă după sursa pe care modelul crede că o imită.
| original_size 128 px | 256 px | 512 px | 1024 px | 2048 px | claimed crop | claimed crop, larger | |
|---|---|---|---|---|---|---|---|
| the empty prompt “”seed 1001 |  |  |  |  |  |  |  |
| seed 1002 |  |  |  |  |  |  |  |
| seed 1003 |  |  |  |  |  |  |  |
Mulțimea și portretul
În fotografiile din care învață modelele, mulțimile sunt văzute de departe, iar oamenii care zâmbesc apar mai ales în portrete. În „Toată lumea, zâmbiți!” am construit modelul Smiling: tot cu UCE, cuvintele pentru oameni duc acum la „o femeie care zâmbește”. Cu el, mulțimile s-au destrămat. Din metroul aglomerat iese în față o tânără care zâmbește. Zidul de muncitori devine cinci oameni care pozează. Cele două surori mici din capătul coridorului devin două chipuri care râd, de aproape. Zâmbetul a venit împreună cu încadrarea portretului. Ipoteza noastră, netestată încă: un chip din mulțime și un chip de portret vin din fotografii diferite și ocupă, în model, locuri diferite. În varianta fotografică, chipurile din mulțime ies mai asemănătoare între ele; când un chip e adus în prim-plan, apare alt fel de om, de catalog.
| STANDARD MODEL | STANDARD MODEL · photographic variant | SMILING · from “Everybody, smile!” | |
|---|---|---|---|
| “commuters standing in a crowded subway car, wide shot…” | 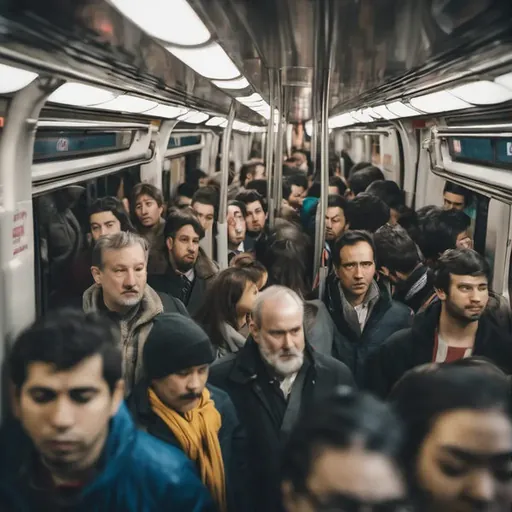 |  |  |
| “a group portrait of factory workers in the 1950s…” |  |  |  |
| “a wide shot of two sisters crying and hugging in a hospital corridor…” |  |  | 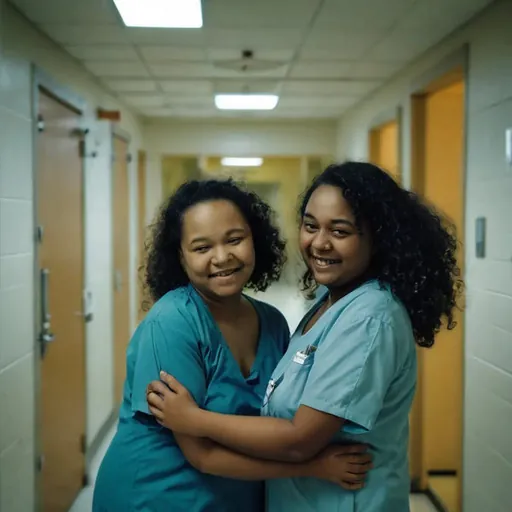 |
Părtinirea nu dispare. Se mută.
În 2023, o analiză Bloomberg a 5.100 de imagini făcute cu Stable Diffusion a arătat că, pentru meserii bine plătite precum „CEO”, „judecător” sau „avocat”, majoritatea celor generați erau bărbați cu pielea deschisă. Companiile care dezvoltă modelele au încercat de atunci să corecteze astfel de înclinații, mai ales în cuvinte: prompturi rescrise, filtre, date reechilibrate. Experimentele de pe această foaie arată că părtinirea nu stă doar în cuvinte. Stă și în parametri pe care utilizatorul nu îi vede, precum mărimea pretinsă a sursei, care schimbă epoca, genul imaginii și chiar cine apare în ea.
claimed size and crop: SDXL micro-conditioning (original_size, crops_coords_top_left), Podell et al., 2023 · the picture is always 1024 px · crowd pictures from the “Everybody, smile!” research, seed 5001
Concluzie
Am căutat masca prin care un model imită o imagine terminată, ca s-o putem scoate. N-am găsit-o în cuvinte: „masterpiece” și „8k” doar decorează. Am găsit-o în felul în care se face imaginea: o miniatură hotărâtă devreme, lustruită trei sferturi din pași, împinsă de CFG departe de un „nimic” care nu e neutru. Și am găsit lentila: fotografiile din care a învățat modelul, cu mărimile, decupajele și oamenii lor.
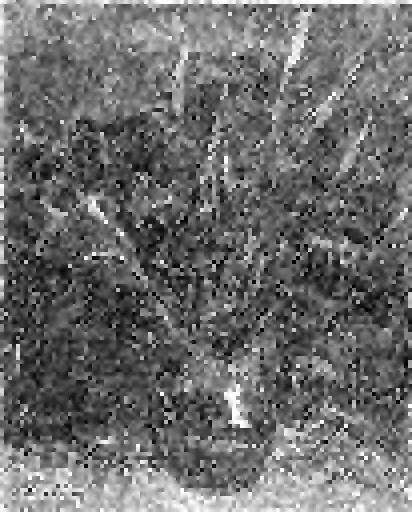
Mai jos, cele două drumuri prin aceeași grilă și același decodor. Pe primul, numerele le scrie fotografia unui tablou. Pe al doilea, le scrie modelul, pornind din zgomot.
1 · Drumul fotografiei
Fotografia tabloului intră în encoderul VAE, devine 4 canale de numere și iese înapoi prin decodor.

encoder


decodor

2 · Drumul generării
Modelul Luchian pornește din zgomot și, în 28 de pași, scrie singur cele 4 canale pentru descrierea „Maci și spice în ulcică”. Același decodor le face pixeli.
28 de pași


decodor
Uitați-vă la cele patru canale de pe fiecare drum. La fotografia tabloului, canalele sunt zgomotoase, macii se ghicesc greu în ele, și totuși imaginea refăcută din ele e plină de materie. La imaginea generată, canalele se citesc aproape ca un desen, iar imaginea finală e netedă. Diferența nu stă în cât de clar e motivul, ci în tot ce e în jurul lui. În fotografie, o bună parte din numere descriu lucruri care nu servesc motivului: firul pânzei, un cocoloș de vopsea, o crăpătură, granulația fotografiei. Nimeni nu le-a vrut; s-au întâmplat. Imaginea generată pornește din zgomot și se strânge, pas cu pas, spre ce e cel mai probabil. Aproape fiecare număr lucrează pentru macii din descriere. E o imagine prea coerentă.
Istoricii de artă cunosc acest fel de diferență. În secolul XIX, Giovanni Morelli atribuia tablourile după detaliile la care nu se uita nimeni, urechile sau unghiile figurilor din fundal: acolo pictorul lucra din obișnuință, iar imitatorul nu se gândea să copieze. Experții în scris spun ceva asemănător despre semnăturile false: falsificatorul desenează semnătura, în loc s-o scrie, și tocmai grija îl trădează. Modelul e un falsificator de acest fel. Reproduce tot ce se observă și pierde tot ce s-a întâmplat.
Un tablou e plin de lucruri care s-au întâmplat. O imagine generată conține doar lucruri care trebuiau să fie acolo.
Methods
- SDXL 1.0 base
- latent diffusion, Rombach et al., CVPR 2022
- SDXL micro-conditioning, Podell et al., 2023
- classifier-free guidance, Ho & Salimans, 2022; oversaturation at high guidance, Sadat et al., ICLR 2025
- x0 prediction
- finish layer: high-pass at 6 px
- VAE round trip: SDXL VAE
- 16-channel latents: Esser et al., 2024
- word diversion: UCE, Gandikota et al., WACV 2024
- detection: Ricker et al., 2024; Corvi et al., 2023; Cozzolino et al., 2024
- human detection: Pocol et al., 2024; Pavão, 2025
- connoisseurship: G. Morelli, Italian Painters, 1890; C. Ginzburg, “Clues”, 1979
- forged signatures: forensic document examination literature, e.g. Puri, 1980
- real-time generation: StreamDiffusion, Kodaira et al., 2023
- bias: Nicoletti & Bass, “Humans Are Biased. Generative AI Is Even Worse”, Bloomberg, 2023; Luccioni et al., “Stable Bias”, 2023
- statistical image: John May, Signal. Image. Architecture., 2019
- September–November 2026
- full reports: BrutAIsm, research table